Photographie datée au 6 octobre 2026 : en 2026, chaque mois apporte son lot de surprises — nouveaux modèles, hausses et baisses de coûts. Voici où en est mon setup, et le harnais qui le tient.
En 2026, chaque mois change la donne
Depuis le début de l’année, je change d’outil de coding en permanence. Pas par toquade : les modèles, les prix et les capacités bougent trop vite pour figer quoi que ce soit.
Cet article n’est donc pas un guide universel. C’est une photographie : mon setup tel qu’il tourne en octobre 2026, et la discipline qui le rend utilisable au quotidien — le Harness Engineering.
C’est quoi, un harnais ?
D’abord, posons le terme. Ce n’est pas de moi, mais c’est la définition sur laquelle je m’appuie :
1. Le harness — tout ce qui entoure le modèle pour en faire un agent capable d’agir : son contexte, ses outils, son environnement d’exécution et ses vérifications.
2. Le harness d’un agent de coding — l’ensemble concret qui encadre son travail sur un projet : règles, Docker, worktrees, MCP, tests, relecture.
3. Le Harness Engineering — concevoir, observer et améliorer cet ensemble pour que l’agent travaille mieux et que ses erreurs soient détectées plus tôt.
Avec mes mots : le harnais, ça permet de contenir la puissance de l’agent pour la mettre dans la bonne direction. C’est le châssis, les roues, les freins et l’airbag d’un moteur surpuissant.
Les agents sont devenus de plus en plus autonomes : ils rebouclent, se retestent. Mon travail, maintenant, c’est de les mettre sur la bonne voie. Avec le bon chemin et la bonne cible, ils exécutent le travail quasiment jusqu’au bout. Quand le harnais est bien mis en place, l’agent boucle tout seul jusqu’à la réussite de sa tâche — tests verts, erreurs constatées puis corrigées.
Pourquoi ça marche maintenant
Deux choses ont basculé en 2026.
D’abord, les agents tiennent des tâches longues et complexes : ils rebouclent, relancent les tests, vérifient le rendu. Ensuite, de mon côté, le coût du token a clairement viré vers le bas au cours de l’été 2026.
Sur les diagrammes de Pareto, on voit le tableau : des modèles très performants et très chers, mais aussi des modèles à très bon marché, un peu moins performants, tout à fait viables pour des tâches de coding complexes.
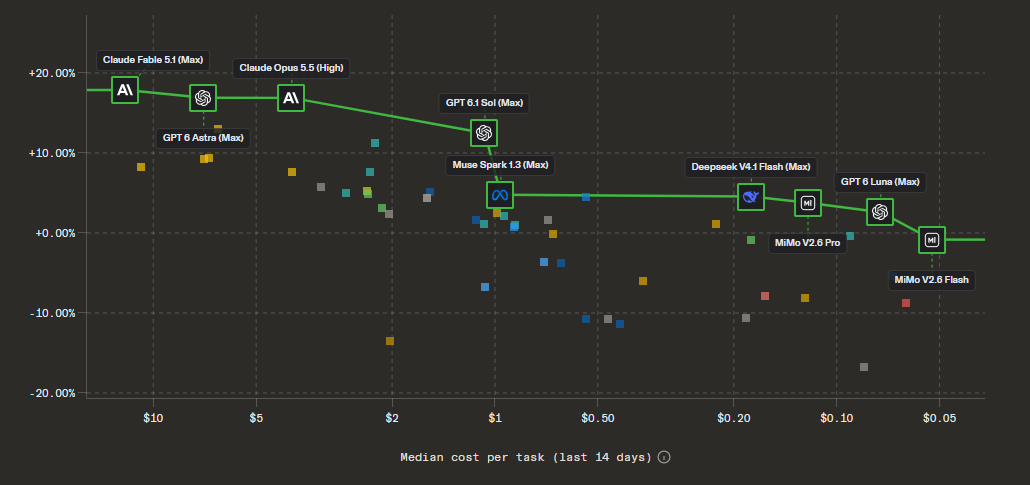
Capture : arena.ai — Pareto code, consulté le 6 octobre 2026. En haut à gauche les modèles les plus performants et les plus chers, en bas à droite les modèles les moins chers — dont ceux que j’utilise au quotidien.
Résultat, sur l’étage du coding : on arrive à produire environ dix fois plus dans le même temps. x10 sur le débit de code — pas sur tout le travail de dev. La gestion de projet, l’évangélisation, la documentation et la revue de code restent soumises à leurs propres goulots d’étranglement.
Mon harnais, concrètement
Les AGENTS.md
Écrits et modifiés par nous. Ils connaissent notre process, notre infra, notre taille d’équipe, notre techno, nos besoins métiers. C’est la partie déjà un peu métier du harnais : l’agent n’improvise pas, il hérite de nos conventions exactes.
Docker partout
Tout est containerisé, sur mon poste comme sur serveur. Même image, mêmes services — préprod, prod, localhost : je déploie vite des applications similaires dans des univers différents, et l’agent travaille toujours dans les mêmes conditions que la prod.
Les worktrees : le multithreading hiérarchisé
Un worktree par tâche, un agent par worktree, en parallèle. C’est le passage de monotâche à multi-fils — je vous renvoie à mon article sur le sujet.
Les MCP : l’agent branché sur mon univers
Les MCP connectent l’agent à la totalité de mon univers de code et aux services extérieurs : Jira et Bitbucket d’abord, puis Chrome DevTools et Playwright pour le test. L’agent voit le rendu de ce qu’il code et boucle jusqu’à constater qu’il n’y a plus d’erreur, ni dans l’interface ni dans le code.
OpenCode en facturation à l’appel + le board de référence
J’utilise OpenCode — agent open source, model-agnostic, en facturation à l’appel. Ça permet de prendre les modèles les moins chers du moment, voire des modèles gratuits, et d’en changer en éditant une ligne de config.
J’ai un board de référence que je regarde quasiment chaque jour pour arbitrer le rapport qualité-prix : on a commencé avec du DeepSeek, continué l’été avec du GLM 5.3, on est maintenant sur du GPT-6 Luna. Chaque jour apporte son lot de nouveaux modèles à comparer — le choix est momentané, assumé.
Cadrer l’agent : TDD, tests, builds, relecture, doc
Un bon harnais ne va pas sans TDD : mettre les tests en amont est très efficace avec un agent. On lui signifie les conditions à remplir, il boucle jusqu’à les avoir remplies.
Chez nous : des tests Dusk dans notre architecture, les lints et les builds pour contenir les erreurs grotesques — même si, avec la performance des agents aujourd’hui, ils en font de moins en moins.
La relecture humaine reste indispensable : c’est notre nom sur le commit, on est responsable du code produit. C’est notre tampon.
Et pour que le prochain agent ait tout de suite les infos à disposition, la documentation est indispensable partout. Les nouveaux modèles affichent des fenêtres de contexte d’un million de tokens — documenter énormément nos process accélère les développements futurs.
Les limites — celles qui restent
Le goulot s’est déplacé. On est très rapides sur le code et l’application en tant que telle, mais l’écriture du cahier des charges, la définition du besoin métier, les choix esthétiques et la direction artistique ne suivent pas toujours. Le produit et l’innovation produit deviennent le facteur limitant.
Et côté temps de cerveau : j’ai l’impression d’une « IA-fatigue ». Des journées à rallonge, cinq ou six sujets en parallèle — comme jouer à la machine à sous en remettant sans cesse une pièce dans le fil pour aller un peu plus loin. L’IA a multiplié ma capacité d’exécution, pas ma capacité de compréhension et de décision.
Conclusion
Ce setup n’est ni un agent autonome ni un simple assistant de code. C’est un environnement de travail conçu pour des agents puissants : Docker et worktrees pour cadrer l’exécution, AGENTS.md pour le contexte, OpenCode pour la liberté de modèle, MCP pour toucher au monde réel, TDD et relecture pour valider.
Le bilan daté au 6 octobre 2026 :
- x10 sur le débit de code, pas sur tout le travail de dev ;
- des modèles qui changent tout le temps — DeepSeek, puis GLM 5.3, puis GPT-6 Luna — arbitrés chaque jour au meilleur rapport qualité-prix ;
- 2 limites structurelles : le produit / besoin métier qui ne suit pas toujours, et mon temps de cerveau — le seul qui ne se scale pas.
La suite ? Un autre article, sur cette nouvelle façon de travailler en multi-fils : comment on supervise plusieurs agents sans perdre le fil — et sans y laisser ses soirées.
Camille Aubert — octobre 2026